Aggiunta di un nuovo cluster nel modulo RESEARCH
In questa procedura viene fornita una descrizione dettagliata su come creare e configurare un ambiente cluster RESEARCH. Ciò include un'opzione di failover tra il nodo di pianificazione e il nodo centrale e/o il failover tra due nodi centrali per ottenere un'alta disponibilità.
Introduzione
Via via che la quantità di dati cresce e la logica aziendale diventa più complessa, sono necessarie ulteriori risorse per calcolare i risultati e fornirli agli utenti. Se si utilizza un sito a nodo singolo (piccolo), le sue prestazioni potrebbero deteriorarsi nel tempo, compromettendo la credibilità e la qualità del modulo RESEARCH di BriefCamMilestone.
Per risolvere questo problema, un cluster di moduli RESEARCH viene utilizzato come architettura distribuita per alleviare i carichi di dati e applicazioni dal server RESEARCH principale che controlla l'intero sito RESEARCH. Il nodo centrale, noto anche come "manager", delega alcuni dei suoi compiti a una macchina secondaria, denominata nodo Scheduler o "worker". Quando riceve l'ID di un'attività dal manager, il lavoratore legge l'attività dal database del repository locale ed esegue i calcoli necessari. Una volta completata l'attività, il lavoratore restituisce lo stato dell'attività (riuscito o non riuscito) al responsabile.
Specifiche hardware per il nodo di pianificazione
Di seguito sono riportati i requisiti minimi per il nodo Scheduler:
CPU | 2 x Intel(R) Xeon(R) Gold 6234 CPU a 3,30 GHz (32 vCPU) |
Memoria | 512 GB |
Memorizzazione | 2 SSD da 100 GB 1 unità SSD da 25,5 TB |
Fasi di implementazione
Aggiunta di un nuovo cluster nel modulo RESEARCH
Per aggiungere un nuovo cluster nel modulo RESEARCH:
Verificare che il server Qlik esistente sia raggiungibile dal nuovo server aprendo il seguente percorso sia in Esplora file che in un browser:
\\[QlikServer]\qlikshare.Assicurarsi che il firewall e l'antivirus siano disabilitati sul nuovo server.
Assicurarsi che sia installato un driver Unicode PostgreSQL (x64). Questo sarà necessario per creare le due connessioni ODBC nel passaggio successivo.
Aggiungere due connessioni ODBC –
RESEARCHeRESEARCHPostgreSQL.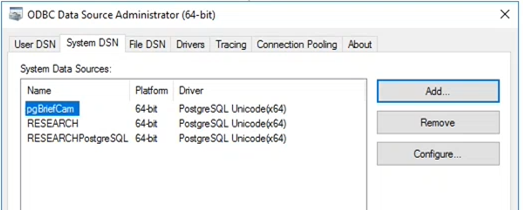
Per la connessione
RESEARCHODBC, eseguire il mapping del database al server del BriefCam database.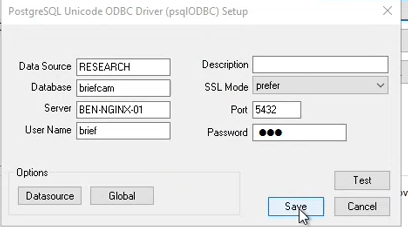
Per la connessione
RESEARCHPostgreSQLODBC, eseguire il mapping del database al server database RESEARCH.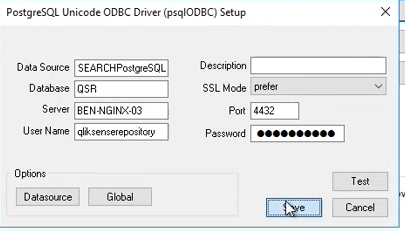
*La porta 4432 deve essere aperta in entrata sulla prima macchina RESEARCH in modo che la seconda macchina RESEARCH possa accedere al suo database Postgres.
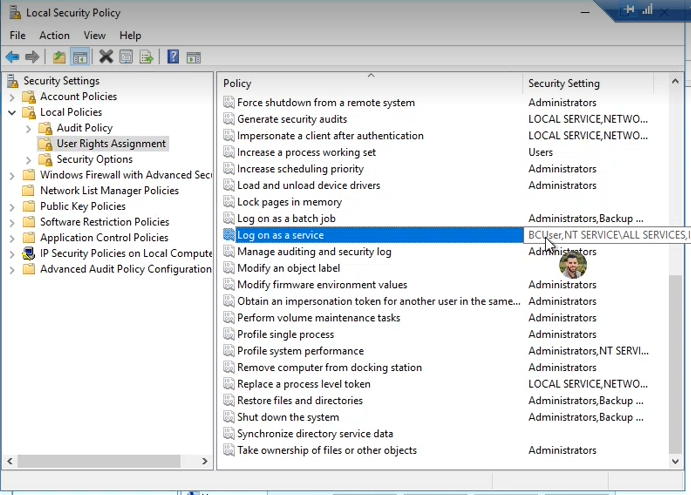
Creazione di un account utente di servizio (per impostazione predefinita, BCUser l'utente che esegue i servizi Qlik). In Gestione computer, verificare che l'utente sia nel gruppo Amministratori.
Assicurarsi che l'utente dell'account di servizio creato nel passaggio precedente sia incluso nei criteri locali Accedi come servizio:
Scaricare il programma di installazione Qlik vanilla (disponibile sul proprio account Git all'indirizzo: https://github.com/qlik-download/qlik-sense-server/releases). È importante che la versione corrisponda a quella installata sul server esistente.
Se si sta installando la versione di Qlik di maggio 2022, scaricare e installare .NET 4.8 Framework Runtime da questo link: https://dotnet.microsoft.com/en-us/download/dotnet-framework/net48.
Sul server Qlik esistente, aprire i servizi Windows e arrestare tutti i servizi Qlik.
Accedere a
ProgramData\Qlik\Sense\Repository\PostgreSQL\12.5(o a qualsiasi versione in possesso) ed eseguire il backup dei seguenti file: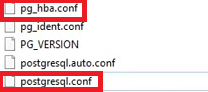
Modificare il
pg_hba.conffile per consentire connessioni non locali: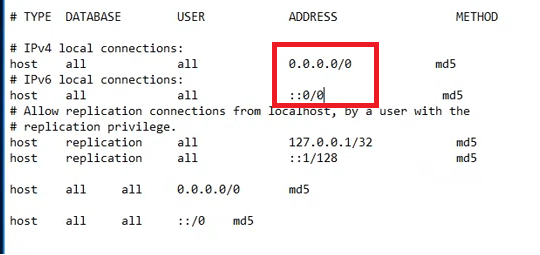
Modificare il
postgresql.conffile per accettare più connessioni da tutti gli indirizzi: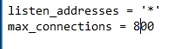
Avviare tutti i servizi Qlik.
Eseguire il programma di installazione di Qlik come amministratore.
Fare clic sul pulsante Unisci a un cluster.
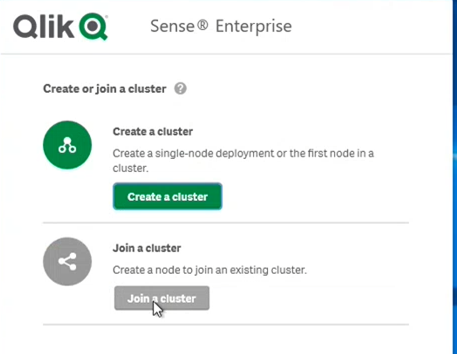
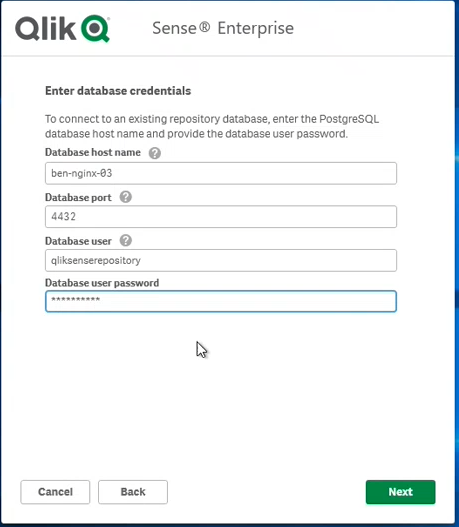
Compilare le credenziali del database (del server Qlik esistente):
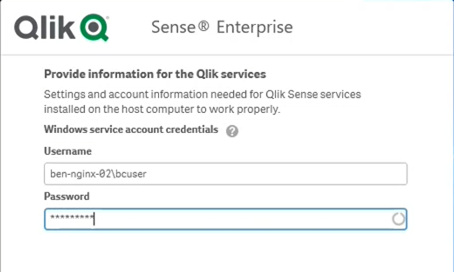
Compilare le credenziali utente dell'account di servizio (quelle definite nel nuovo server):
Dopo aver installato Qlik, installa la patch pertinente alla tua versione (maggio 2022 o novembre 2020).
Accedere al server Qlik esistente e aprire il QMC (
https://localhost/qmc).Seleziona Nodi.
Fare clic su
 Crea nuovo nella barra delle azioni.
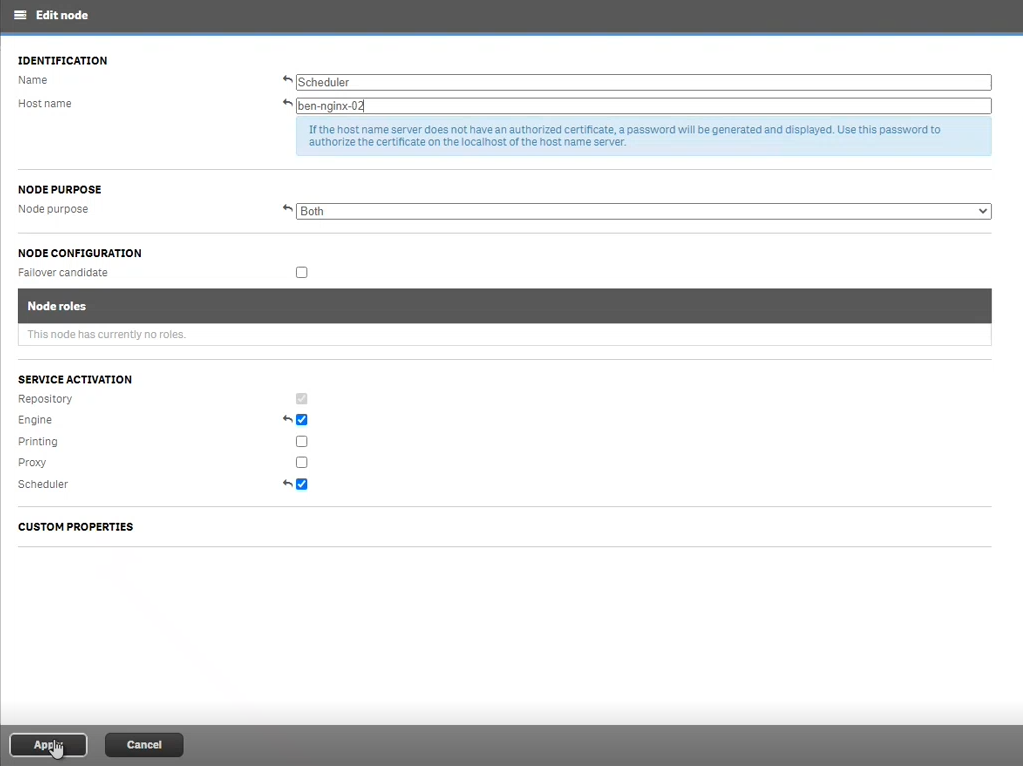
Compila i parametri come mostrato nell'immagine sottostante con il campo Nome host impostato sul nome host del server Qlik appena installato.
Fare clic su Applica e attendere alcuni secondi.
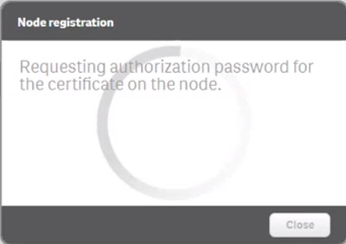
Se il server non riesce a raggiungere l'host remoto, verrà visualizzato il seguente messaggio "Registrazione del nodo".
Controllare la connettività tra il nodo centrale e il nodo Scheduler.
Utilizzando il ping, verificare che IPV6 e il firewall siano disabilitati su entrambi i nodi.
Fare nuovamente clic su Applica. Attendi di ricevere una password di autorizzazione e un URL. La connettività avviene tramite la porta 4444.
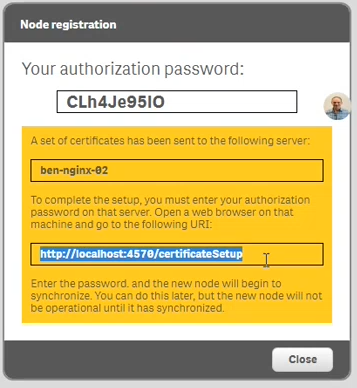
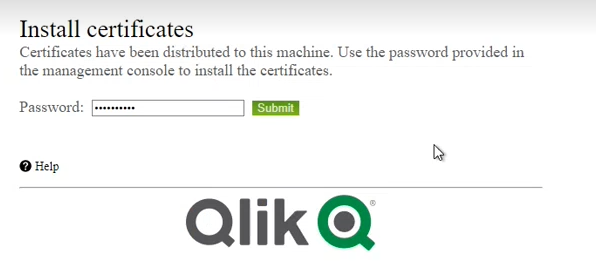
Accedere al nuovo server Qlik, aprire l'URL del passaggio precedente: http://localhost:4570/certificateSetup e immettere la password del passaggio precedente:
Sul server Qlik originale (non sul nuovo cluster), riavviare tutti i servizi Qlik.
Assicurarsi di ottenere i seguenti risultati nella schermata Nodi del QMC:
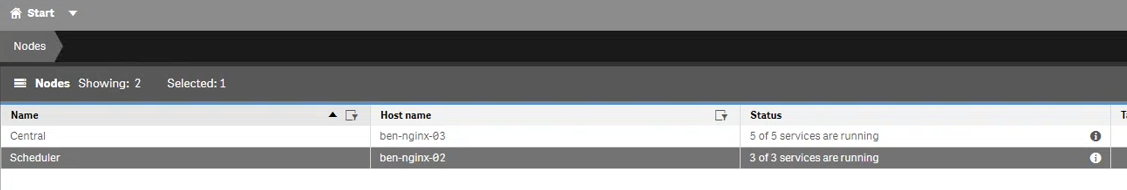
Ciò significa che ora ci sono due server Qlik (multi-nodo): Central e Scheduler.
Nella sezione Programmazioni del QMC, modificare il nodo Centrale e impostare il campo Tipo su Manager:
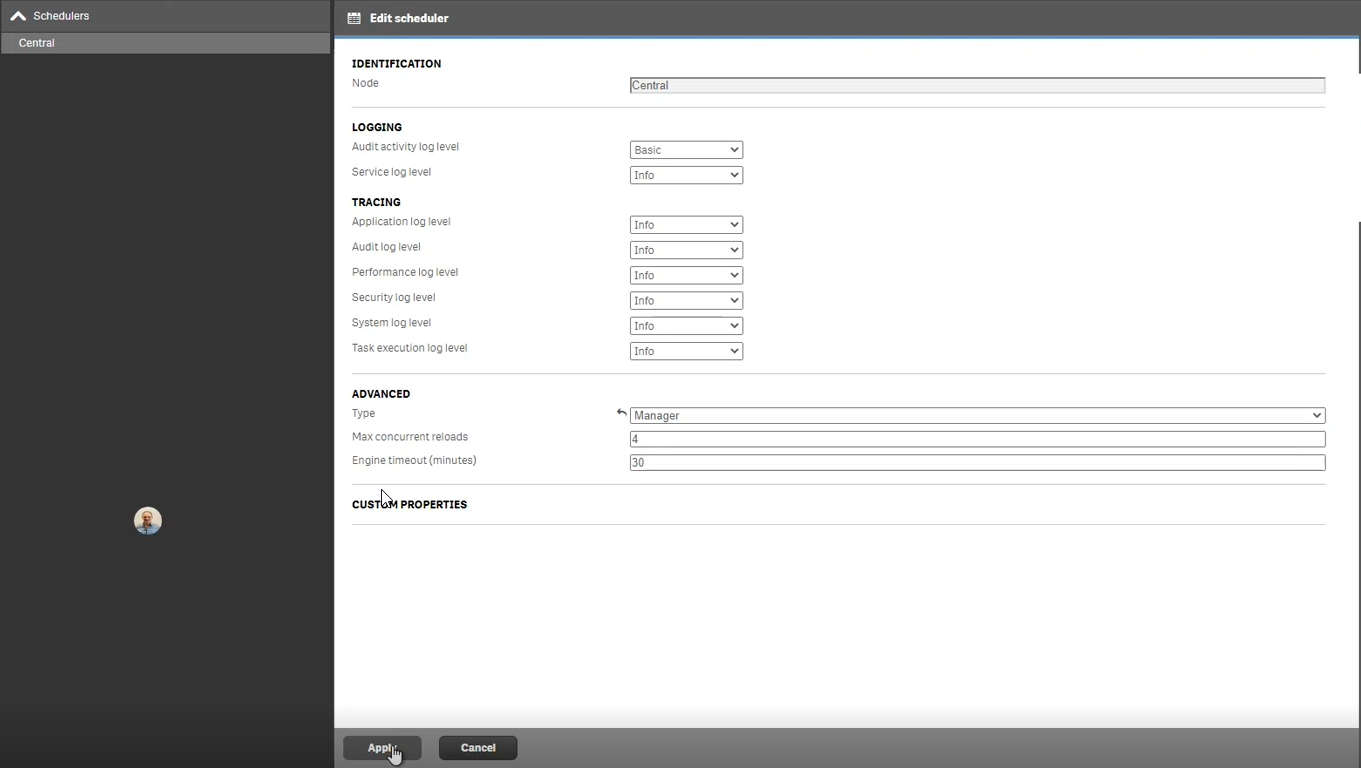
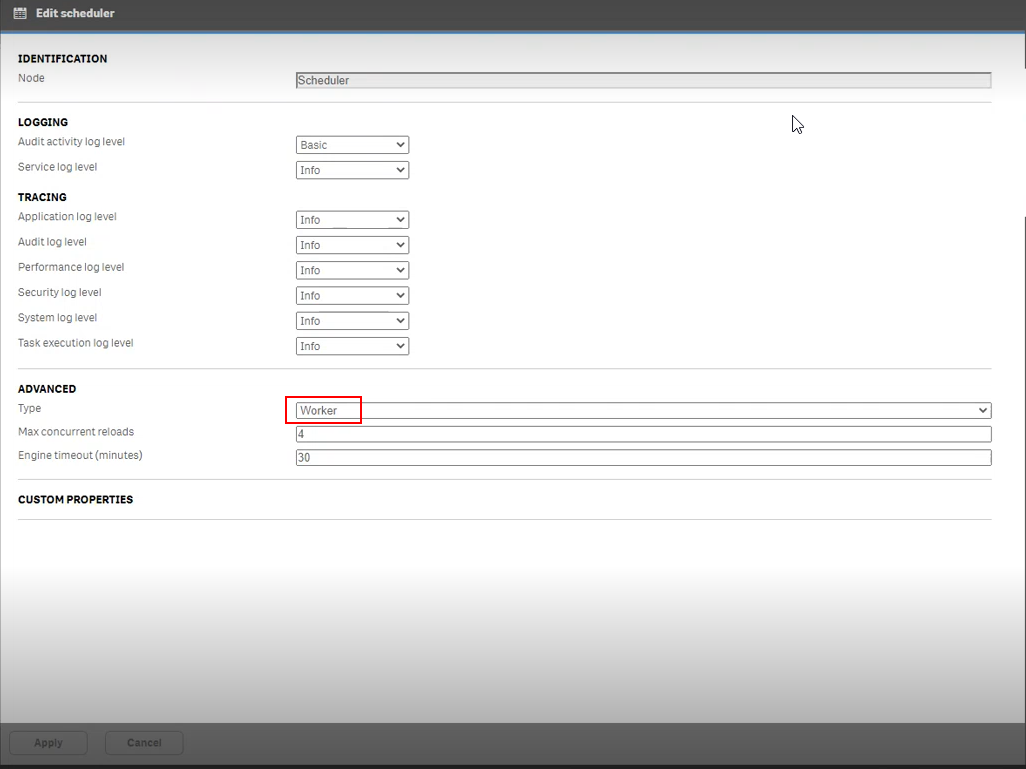
Nella sezione Scheduler del QMC, modificare il nodo Scheduler e impostare il campo Tipo su Worker:
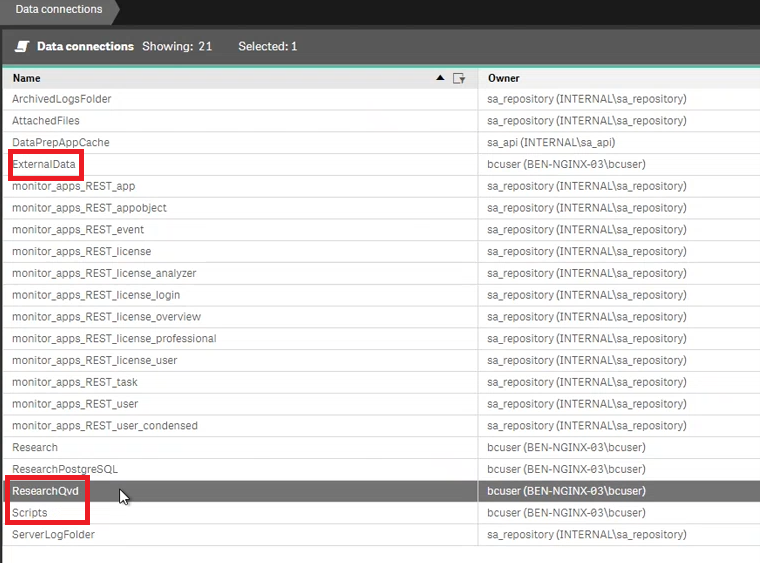
Nella schermata Connessioni dati del QMC, modificare le seguenti tre connessioni:
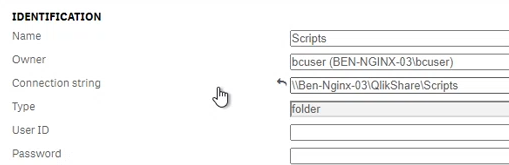
Per ognuna delle tre connessioni, nel campo Stringa di connessione, invece del percorso locale (come l'unità c:), cambiarla in modo che funzioni con il percorso di rete, ovvero il nome host in cui esiste la cartella QlikShare (il server in cui è stato originariamente installato RESEARCH):
Sul nuovo server, apri la sezione Attività del QMC e assicurati che sia
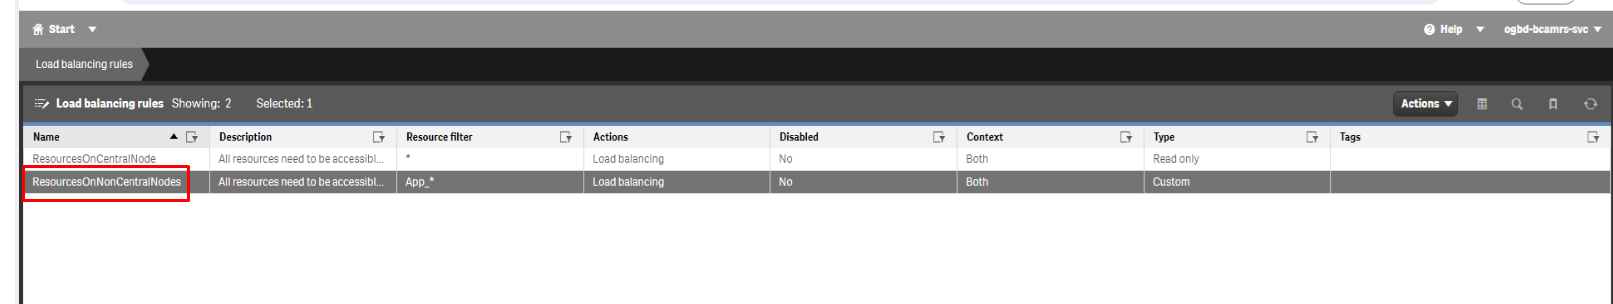
research_dbl'app che l'Researchapp siano in esecuzione correttamente.In QMC (nodo centrale), accedere alla sezione Regole di bilanciamento del carico.
Fare doppio clic su ResourcesOnNonCentralNodes.
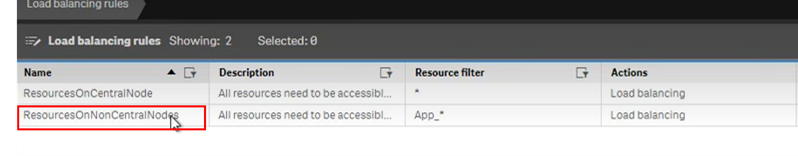
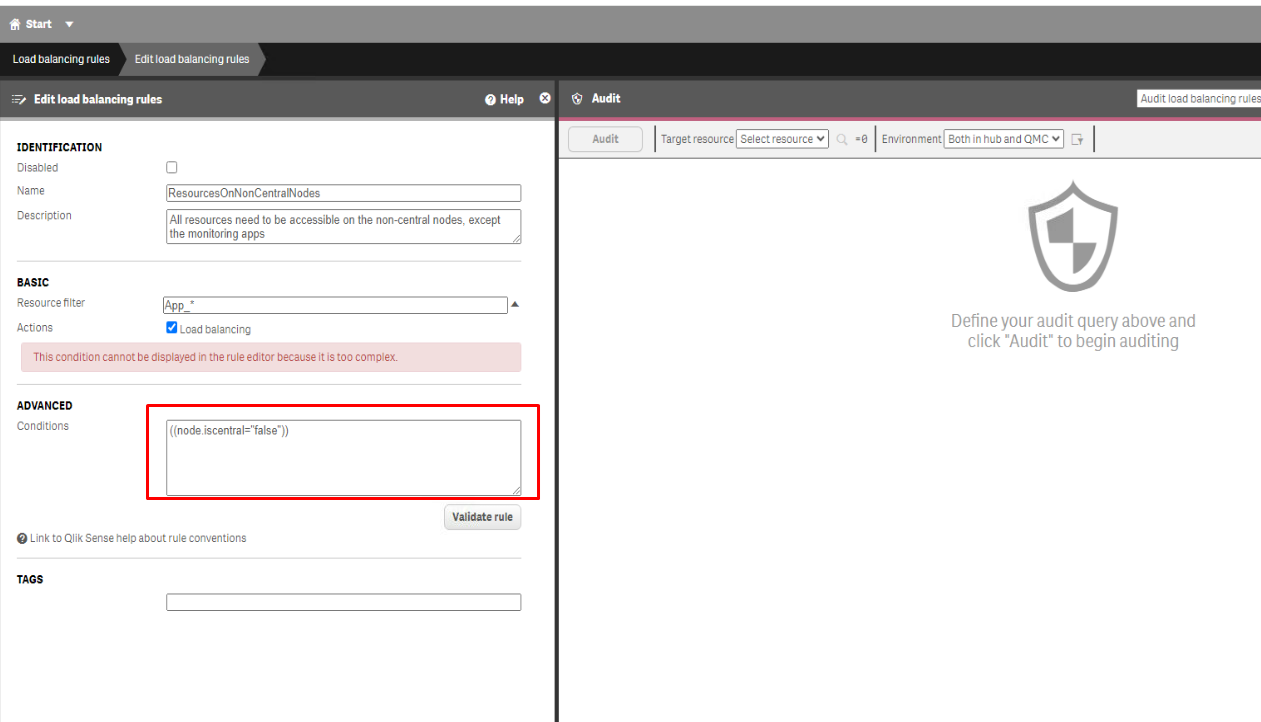
Rimuovi la sezione contrassegnata mostrata nell'immagine sottostante.
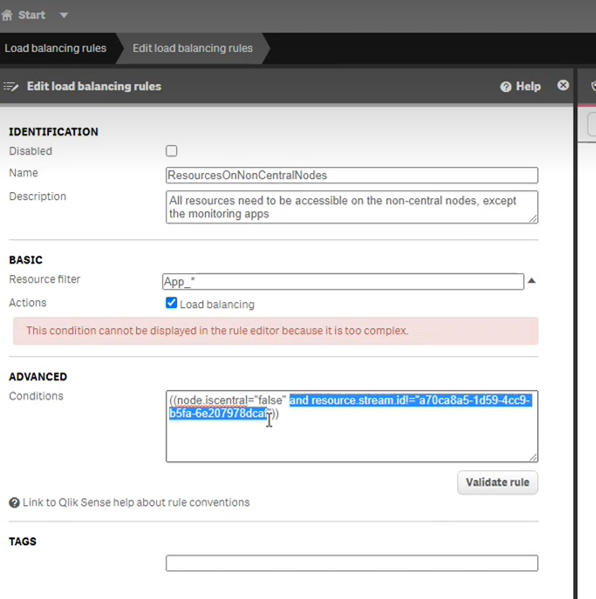
Forzare il failover manuale tra lo scheduler e il nodo centrale
Per forzare il failover manuale tra il nodo Scheduler e il nodo Centrale, eseguire i seguenti passaggi:
In QMC (server centrale), selezionare il menu Schedulers.
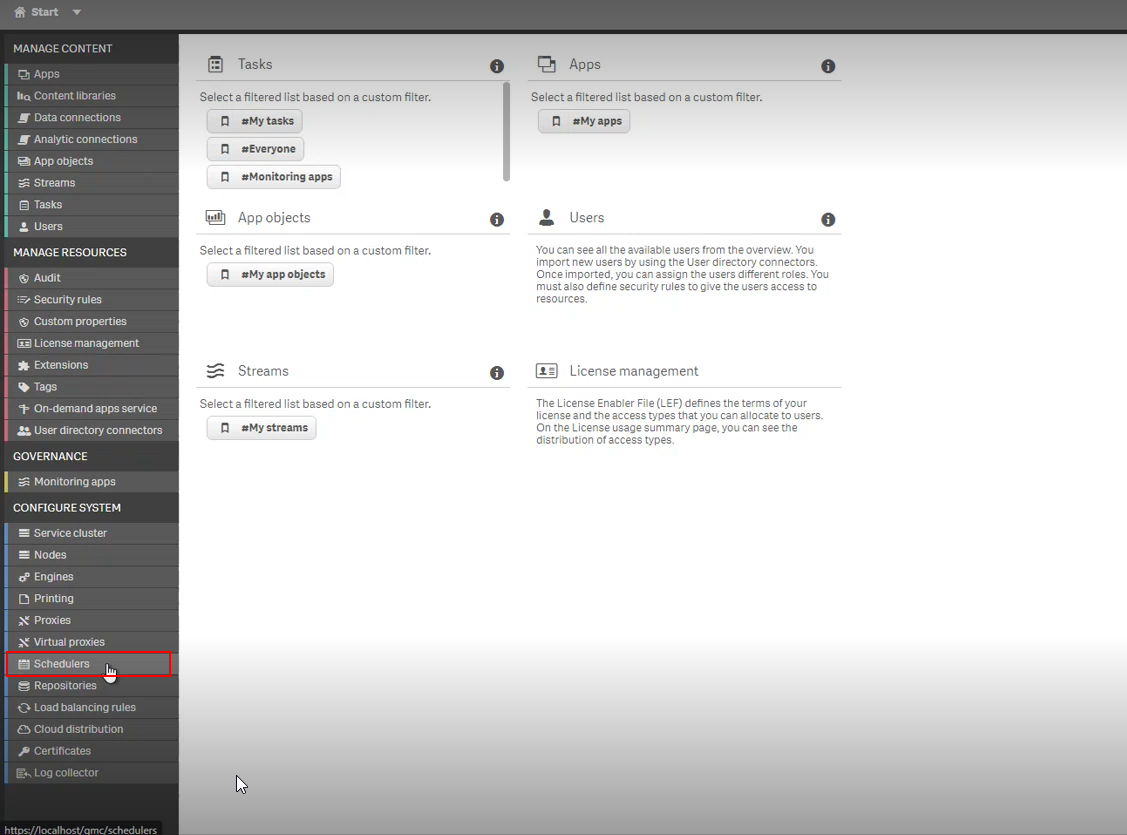
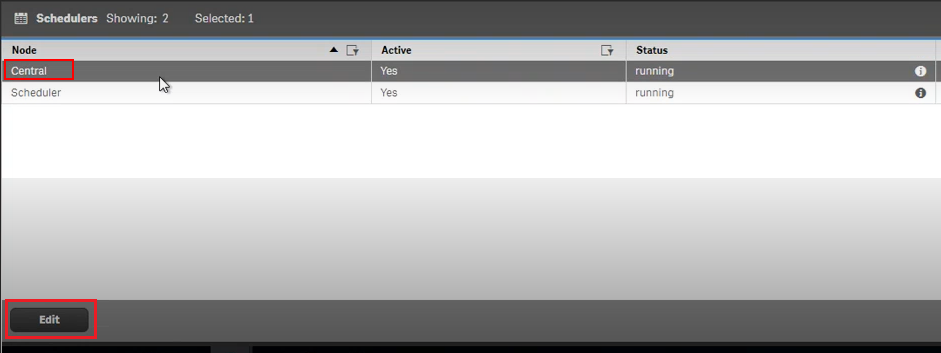
Selezionare la pianificazione centrale e fare clic sul pulsante Modifica.
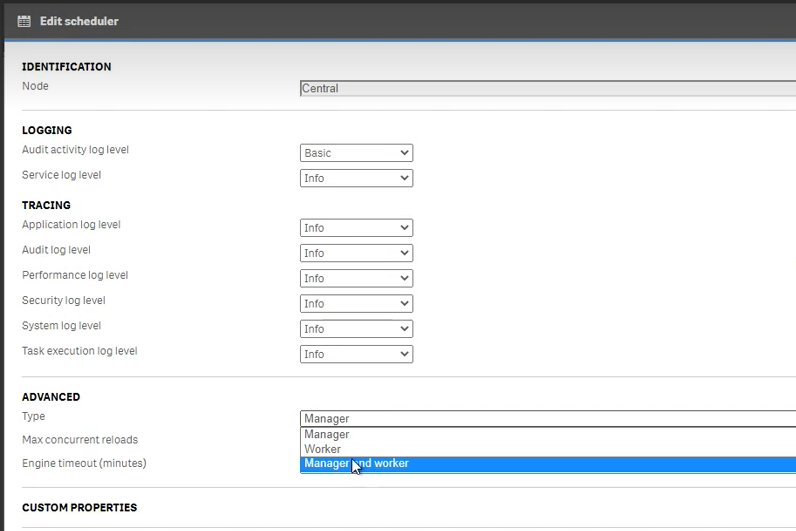
Nel campo Tipo della sezione Avanzate, selezionare Responsabile e lavoratore. Il nodo centrale tornerà al suo stato iniziale (server standalone). Il nodo Scheduler smetterà di funzionare come membro del cluster (e alla fine non sarà in uso).
Modifica delle risorse della regola di bilanciamento del carico sui nodi non centrali
Dalla pagina iniziale di QMC, aprire Regole di bilanciamento del carico.
Selezionare la regola ResourcesOnNonCentralNode e fare clic su Modifica.
Nella sezione Avanzate, modificare la condizione come segue:
((node.iscentral="false"))Fai clic su Applica.
Verifica che dopo questa modifica tutte le attività di QMC funzionino correttamente, comprese le attività di licenza e operative.
Failover del nodo centrale (opzionale)
Per evitare di avere un singolo punto di errore in un sito multinodo, quando si aggiunge un nuovo nodo alla distribuzione è possibile assegnargli il ruolo di candidato al failover. Ciò significa che qualsiasi server o nodo nel sito RESEARCH può svolgere lo stesso ruolo del nodo centrale. Il ruolo del nodo centrale può ora essere scambiato, ad esempio se il nodo centrale è stato offline per più di 10 minuti.
Se si desidera eseguire il backup del nodo centrale:
Definire un server centrale aggiuntivo (un nuovo nodo centrale con le stesse specifiche del nodo originale).
In QMC (del nodo centrale aggiuntivo), selezionare il menu Nodi e definirlo come candidato al failover.
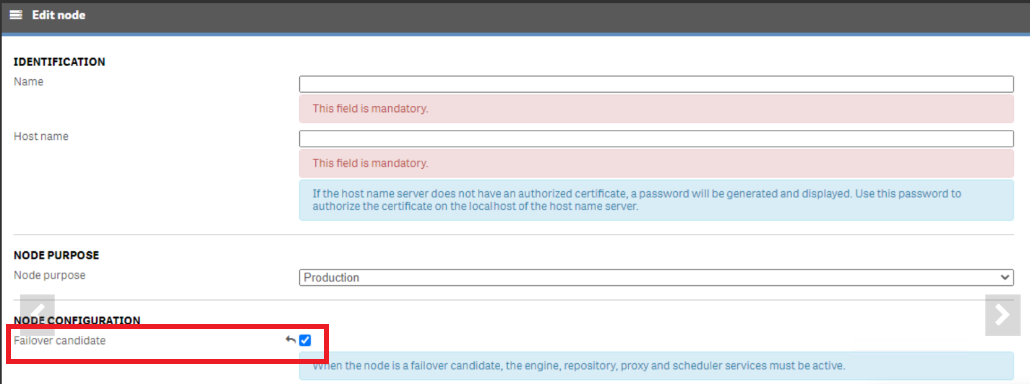
Dopo aver configurato un nodo per diventare un candidato al failover, ogni nodo del sito controllerà regolarmente il nodo primario (nodo centrale) per verificare che il nodo centrale sia attivo. Se non c'è comunicazione tra il nodo primario e gli altri nodi del sito dopo 10 minuti, il nodo primario verrà sostituito dal successivo nodo disponibile. Se più di un nodo è impostato come candidato al failover, ogni nodo competerà per ottenere una protezione su un campo del database e il vincitore diventa il nodo centrale. C'è un campo aggiuntivo nel QMC per mostrare quale nodo è attualmente il nodo centrale.